flociを使ってCDKのテストをやってみている(うまくいかない)

クラウドサービスのエミュレータのひとつにflociというものがあります。

floci.io

AWSでは執筆時点で68個のサービスに対応しています。

floci.io

これを使ってAWS CLIなどの簡単な動作確認をしています。例えば、以下のようなcompose.yamlを用意してdocker compose upで起動しておきます。

services:
  floci:
    image: floci/floci:1.5.33
    ports:
      - "4566:4566"
    volumes:
      - ./data:/app/data

あとはエンドポイントやアクセスキーなどを環境変数で指定しておけば、flociに対してAWS CLIのコマンドを実行できます。以下はS3バケットを作成する例。

$ export AWS_ENDPOINT_URL=http://localhost:4566
$ export AWS_ACCESS_KEY_ID=test AWS_SECRET_ACCESS_KEY=test
$ aws s3 mb s3://my-bucket
make_bucket: my-bucket
$ 

なお、S3の厳密な命名規則は実装していないようで、命名規則に反しているバケットも作成できました。以下はS3の命名規則。

docs.aws.amazon.com

実行例は以下のとおり。

$ aws s3 mb s3://my_bucket
make_bucket: my_bucket
$ aws s3 mb s3://MY-BUCKET
make_bucket: MY-BUCKET
$

さて、このflociを使ってCDKのテストをやってみているのが今日のブログネタです。結論から言うと、うまくいっていません。

まずはbootstrapがうまく動きません。

$ cdk bootstrap
 ⏳  Bootstrapping environment aws://000000000000/ap-northeast-1...
Trusted accounts for deployment: (none)
Trusted accounts for lookup: (none)
Using default execution policy of 'arn:aws:iam::aws:policy/AdministratorAccess'. Pass '--cloudformation-execution-policies' to customize.
CDKToolkit: creating CloudFormation changeset...
21:28:12 | CREATE_FAILED           | AWS::ECR::Repository       | ContainerAsse
tsRepository
Failed to start ECR backing registry container: java.net.SocketException: No su
ch file or directory

どうしようかと思っていたところ、以下のブログを見つけました。

zenn.dev

Bootstrap時に作成しようとしているECRを作らないようにテンプレートをしていたところうまく動きました。

その後、 簡単なS3バケットをつくる以下のCDKを実行したところ、うまく動きませんでした。

import { Stack, StackProps, RemovalPolicy } from 'aws-cdk-lib';
import { Bucket } from 'aws-cdk-lib/aws-s3';
import { Construct } from 'constructs';

export class InfraStack extends Stack {
  constructor(scope: Construct, id: string, props?: StackProps) {
    super(scope, id, props);

    new Bucket(this, 'Bucket', {
      removalPolicy: RemovalPolicy.DESTROY,
    });
  }
}

メッセージは以下のとおり。

$ cdk deploy

✨  Synthesis time: 1.43s

InfraStack: start: Building InfraStack Template
InfraStack: success: Built InfraStack Template
InfraStack: start: Publishing InfraStack Template (current_account-current_region-a23eb08b)
InfraStack: fail: getaddrinfo ENOTFOUND cdk-hnb659fds-assets-000000000000-ap-northeast-1.localhost
Failed to publish asset InfraStack Template (current_account-current_region-a23eb08b)
$ 

今日のところはここまで。

Checkovと生成AIによるIaCコードのレビューシステム構築4 - ReactでWeb UIを実装する

はじめに

これまで、Checkovと生成AIを使ったIaCコードレビューシステムを作ってきました。

これまでの記事では、以下のような処理を実装しています。

  1. CloudFormationテンプレートを受け取る
  2. Checkovを実行してIaCコードをチェックする
  3. Checkovの結果をAmazon S3に保存する
  4. CloudFormationテンプレートとCheckovの結果を生成AIに渡す
  5. 生成AIによるレビュー結果をJSON形式で保存する

生成AIの出力については、当初Markdown形式を想定していましたが、後続処理や画面表示を考慮してJSON形式に変更しました。

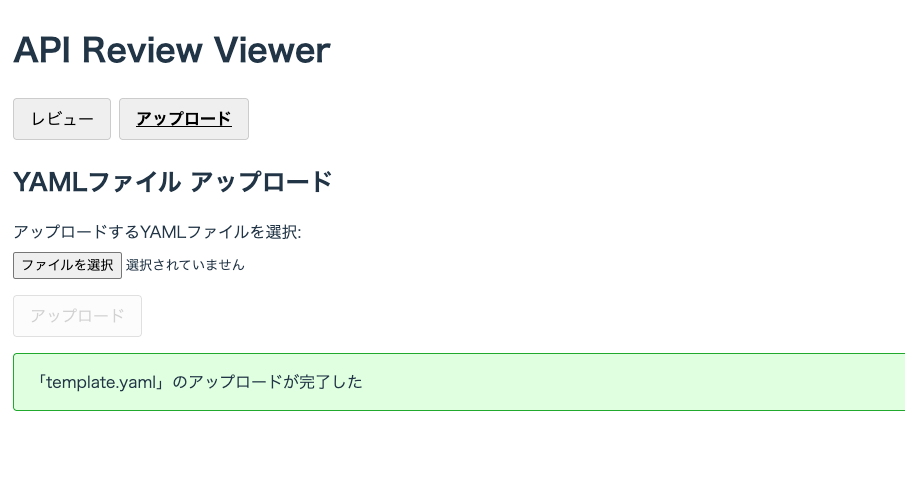
今回は、これまでバックエンド中心だったシステムに対して、Reactを使ったWeb UIを実装しました。

今回の主な変更点は次のとおりです。

  • ReactによるWeb UIの実装
  • CloudFormationテンプレートのアップロード
  • Amazon S3 Presigned URLを利用したファイルアップロード
  • API GatewayのCORS設定
  • APIから取得したレビュー結果の画面表示

今回実装した構成

今回のシステム全体の構成は次のようになりました。

+----------------+
|    React UI    |
+--------+-------+
         |
         | 1. ジョブ作成
         v
+----------------+
|  API Gateway   |
+--------+-------+
         |
         v
+----------------+
|     Lambda     |
+--------+-------+
         |
         | 2. Presigned URLを発行
         v
+----------------+
|       S3       |
+----------------+
         ^
         |
         | 3. ブラウザから直接アップロード
         |
+--------+-------+
|    React UI    |
+----------------+

         |
         | 4. レビュー開始
         v

+----------------+
| Step Functions |
+--------+-------+
         |
         v
+----------------+
| ECS RunTask    |
|   (Checkov)    |
+--------+-------+
         |
         v
+----------------+
| Amazon Bedrock |
|  GenerateReport|
+----------------+
         |
         v
+----------------+
|       S3       |
|  Review Report |
+----------------+

今回、特に実装したのはReactからS3へのファイルアップロード部分です。

API Gatewayを経由してファイルをアップロードしない

以下の記事でも書きましたが、ファイルアップロードには署名付きURLを使います。

miyohide.hatenablog.com

React側では、まずAPIを呼び出してPresigned URLを取得します。

      const uploadResponse = await fetch(`${apiEndpoint}/upload`, {
        method: "POST",
        headers: {
          Authorization: token,
          "Content-Type": "application/json",
        },
        body: JSON.stringify({ filename: file.name }),
      });

      if (!uploadResponse.ok) {
        throw new Error(
          `Presigned URL の取得に失敗した: ${uploadResponse.status} ${uploadResponse.statusText}`
        );
      }

      const { presigned_url } = (await uploadResponse.json()) as { presigned_url: string };

      if (!presigned_url) {
        throw new Error("レスポンスに presigned_url が含まれていない");
      }

取得したPresigned URLに対して、ファイルをPUTします。

      const putResponse = await fetch(presigned_url, {
        method: "PUT",
        headers: {
          "Content-Type": "application/x-yaml",
        },
        body: file,
      });

      if (!putResponse.ok) {
        throw new Error(
          `ファイルのアップロードに失敗した: ${putResponse.status} ${putResponse.statusText}`
        );
      }

      setMessage(`「${file.name}」のアップロードが完了した`);
      setFile(null);
      if (fileInputRef.current) {
        fileInputRef.current.value = "";
      }

この処理により、ファイルの内容はAPI GatewayやLambdaを経由せず、S3へ直接アップロードされます。

CORSでエラーになる

ここまで実装して、ReactからAPI Gatewayを呼び出してみました。

すると、ブラウザから次のようなエラーが発生しました。

Access to fetch at 'https://xxxxx.execute-api.ap-northeast-1.amazonaws.com/...'
from origin 'http://localhost:5173'
has been blocked by CORS policy

ブラウザから別のオリジンに対してHTTPリクエストを送信する場合、CORS(Cross-Origin Resource Sharing)の設定が必要になります。

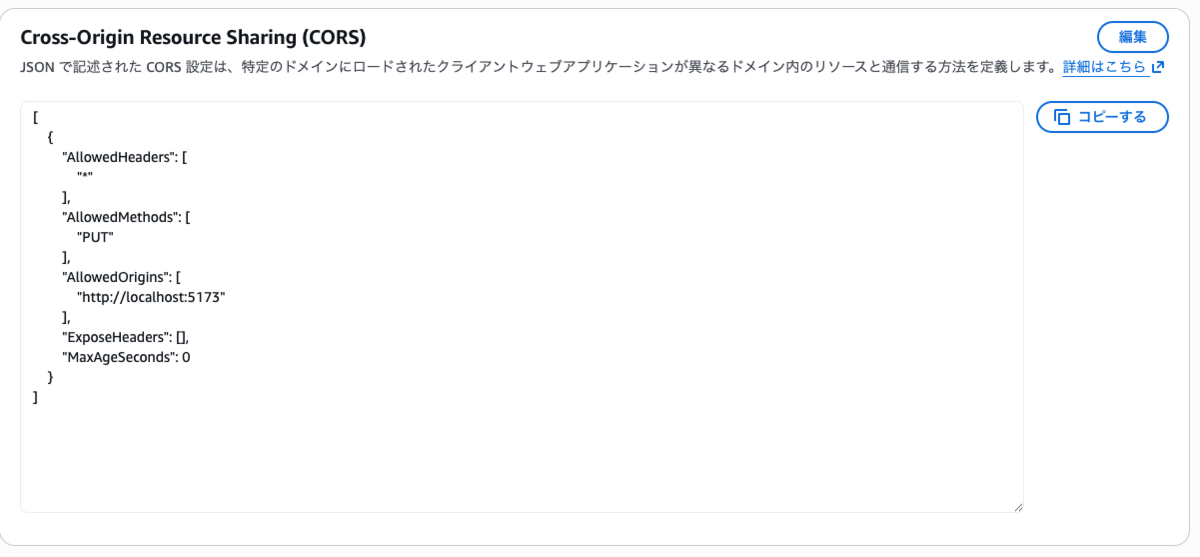
同様にS3にもCORS設定が必要です。

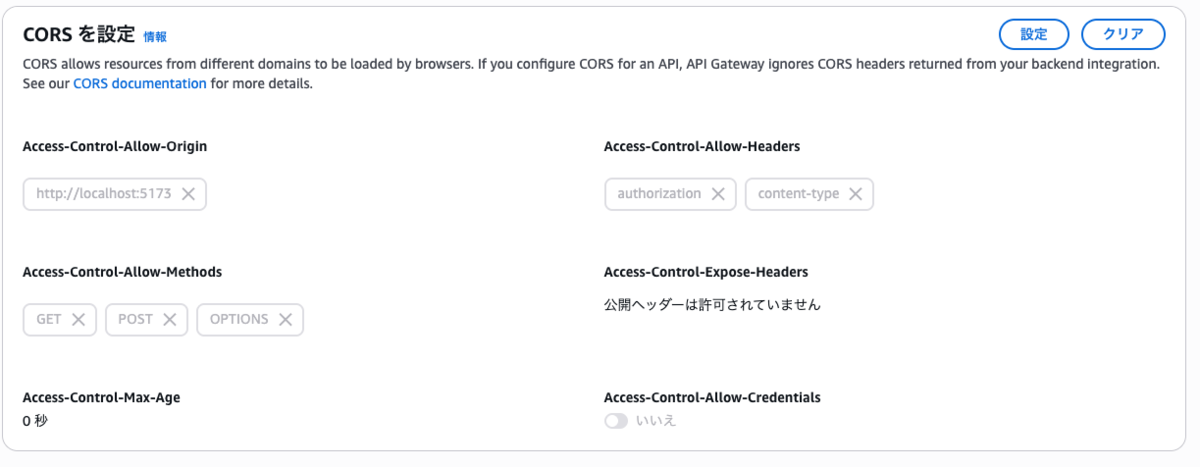
これを手作業でやるのも面倒なので、CDKで実装すると良いかと思います。API Gatewayに対しては以下のように実装します。

    const httpApi = new apigwv2.HttpApi(this, "HttpApi", {
      apiName: "api-review",
      corsPreflight: {
        allowOrigins: ["http://localhost:5173"],
        allowMethods: [apigwv2.CorsHttpMethod.GET, apigwv2.CorsHttpMethod.POST, apigwv2.CorsHttpMethod.OPTIONS],
        allowHeaders: ["Authorization", "Content-Type"],
      },
    });

S3に対しては以下のように実装します。

    const uploadBucket = new s3.Bucket(this, "UploadBucket", {
      bucketName: `api-review-uploads-${cdk.Aws.ACCOUNT_ID}`,
      removalPolicy: cdk.RemovalPolicy.DESTROY,
      autoDeleteObjects: true,
      cors: [
        {
          allowedMethods: [s3.HttpMethods.PUT],
          allowedOrigins: ["http://localhost:5173"],
          allowedHeaders: ["*"],
        },
      ],
    });

動作確認

実際に動作を確認すると、無事動くことが確認できました。

今回の実装で分かったこと

今回、フロントエンドの実装を行うことでCORSの設定が複数箇所に必要になることに気がつきました。具体的には、次の2箇所です。

  • API GatewayのCORS設定
  • S3バケットのCORS設定

また、S3へのアップロードでは、ファイルの内容をAPI GatewayやLambdaに通さず、Presigned URLを使って直接S3へアップロードすることで、シンプルな構成にすることができました。

まとめ

今回は、これまで作ってきたCheckovと生成AIによるIaCコードレビューシステムに、ReactによるWeb UIを追加しました。これで、これまではAPIを直接呼び出して確認していたレビュー処理を、ブラウザから実行できるようになりました。システムとしては、かなり形になってきたように思います。

AWS CodeBuildのアップデート:Amazon Linux 2から2023への移行

今日は小ネタ。

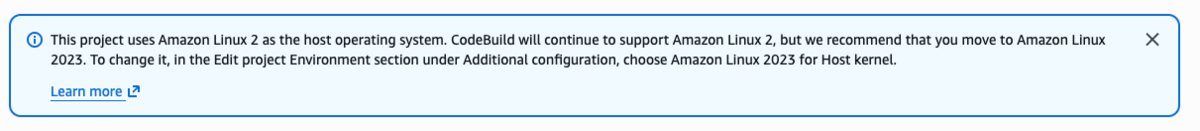
AWS CodeBuildを開いたら、以下のメッセージに気がつきました。

日本語で書くと以下のようです。

  • Amazon Linux 2がEOLとなったが、CodeBuildではAmazon Linux 2は継続してサポートする
  • ただ、Amazon Linux 2023に移行することを推奨する

明示的にAmazon Linux 2を使うように設定した覚えはないのですが、Amazon Linux 2023に移行することにしました。

設定項目

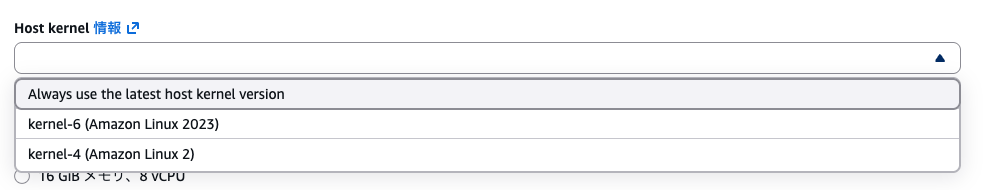
設定項目は「環境」の「追加設定」の中にある「Host kernel」です。設定項目を見ると、以下の3つでした。

  • Always use the latest host kernel version
  • kernel-6 (Amazon Linux 2023)
  • kernel-4 (Amazon Linux 2)

これをkernel-6(Amazon Linux 2023)を設定してあげたらOKです。

すべてのプロジェクトの設定値を確認するには、AWS CLIを使って以下のコマンドを打てば良いです。

$ aws codebuild batch-get-projects \
  --names $(aws codebuild list-projects --query 'projects' --output text) \
  --query 'projects[].{Project: name, HostKernel: environment.hostKernel}' \
  --output table
------------------------------------------------
|               BatchGetProjects               |
+----------------------+-----------------------+
|       Project        |      HostKernel       |
+----------------------+-----------------------+
| my-project-1         | LINUX_KERNEL_4            |
| my-project-2         | LINUX_KERNEL_6            |
| my-project-3         | None                  |
+----------------------+-----------------------+

ちなみに、この値はビルドごとに上書きすることが可能です。マネジメントコンソールにて「上書きでビルドを開始する」を選択すると設定する画面が出てくるので、HostKernelの値の変化によるビルドの違いを確認するにはこの方法を試すと良いかと思います。

Checkovと生成AIによるIaCコードのレビューシステム構築3

はじめに

以前の記事で、生成AIを使ってレポートを作成するLambda関数を実装しました。

miyohide.hatenablog.com

当初は生成結果をMarkdown形式で出力していました。これは人が読むには非常に便利なのですが、実際にシステムを作り始めると少し問題が見えてきました。

今回作っている仕組みでは、AIが生成した内容をそのまま画面へ表示するだけではありません。今後は例えば

  • 指摘事項だけを一覧表示したい
  • 重要度で並び替えたい
  • 指摘件数を集計したい
  • PDFやPowerPointへ変換したい
  • 後続のAIに入力として渡したい

といった処理を考えると、Markdown出力ではこれらを実現するたびにパース処理を書く必要があります。そこで、出力結果をJSONにすることにしました。

プロンプトだけでJSONを強制するのは難しい

プロンプトで JSONのみを出力してください とお願いすることはできますが、余計な文章が付いたり、JSONの途中で改行が崩れたり、キー名が微妙に変わったりすることがあります。人が読む分には問題ありませんが、プログラムで扱うには非常に困ります。JSONとしてパースできなければ、その後の処理がすべて止まってしまいます。

Structured Outputを使う

Amazon BedrockのStructured Outputを利用するようにしました。Structured Outputでは、あらかじめJSON Schemaを定義しておきます。生成AIはそのSchemaに従ったJSONだけを返してくれます。

ただし、Amazon Nova Lite 2ではStructured Outputには対応していません。公式ドキュメントの日本語版では「構造化出力」と表現されているものです。

docs.aws.amazon.com

そこでサポートしているGemma 3 27B PTを使うことにしました。

docs.aws.amazon.com

実装

具体的な実装は以下のとおり。

require "json"
require "aws-sdk-s3"
require "aws-sdk-dynamodb"
require "aws-sdk-bedrockruntime"

def lambda_handler(event:, context:)
  s3 = Aws::S3::Client.new
  dynamodb = Aws::DynamoDB::Client.new

  input_bucket = ENV.fetch("INPUT_BUCKET")
  output_bucket = ENV.fetch("OUTPUT_BUCKET")
  table_name = ENV.fetch("TABLE_NAME")

  job_id = event["jobId"]

  begin
    # DynamoDBからキー情報を取得
    item = dynamodb.get_item(
      table_name: table_name,
      key: { "jobId" => job_id }
    ).item

    raise "Job not found: #{job_id}" if item.nil?

    template_key = item["templateKey"]
    checkov_key = item["checkovKey"]

    template = s3.get_object(
      bucket: input_bucket,
      key: template_key
    ).body.read

    checkov = s3.get_object(
      bucket: output_bucket,
      key: checkov_key
    ).body.read

    prompt = build_prompt(
      template: template,
      checkov: checkov
    )

    # ステータスを GENERATING_REPORT に更新
    update_status(dynamodb, table_name, job_id, "GENERATING_REPORT")

    report = generate_report(prompt)

    # ステータスを COMPLETED に更新
    update_status(dynamodb, table_name, job_id, "COMPLETED")

    report_key = "jobs/#{job_id}/report/report.json"

    s3.put_object(
      bucket: output_bucket,
      key: report_key,
      body: report,
      content_type: "application/json"
    )

    # DynamoDB に reportJSONKey を記録(review-api が参照する)
    dynamodb.update_item(
      table_name: table_name,
      key: { "jobId" => job_id },
      update_expression: "SET reportJSONKey = :key, updatedAt = :updated_at",
      expression_attribute_values: {
        ":key" => report_key,
        ":updated_at" => Time.now.utc.iso8601
      }
    )

    {
      reportKey: report_key
    }
  rescue => e
    # 失敗時はステータスを FAILED に更新
    update_status(dynamodb, table_name, job_id, "FAILED") if job_id
    raise e
  end
end

def update_status(dynamodb, table_name, job_id, status)
  dynamodb.update_item(
    table_name: table_name,
    key: { "jobId" => job_id },
    update_expression: "SET jobStatus = :status, updatedAt = :updated_at",
    expression_attribute_values: {
      ":status" => status,
      ":updated_at" => Time.now.utc.iso8601
    }
  )
end

# Checkovの解析結果JSONから失敗チェックのみを抽出し、
# check_id, check_name, resource の最小限の情報に要約する。
# LLMに渡すプロンプトのトークン数を抑えるための前処理。
def summarize_checkov(json_text)
  data = JSON.parse(json_text)

  failed =
    data
      .dig("results", "failed_checks") || []

  failed.map do |c|
    {
      id: c["check_id"],
      name: c["check_name"],
      resource: c["resource"],
      file_line_range: c["file_line_range"]
    }
  end
end

def build_prompt(template:, checkov:)
  failed_checks =
    JSON.pretty_generate(
      summarize_checkov(checkov)
    )

  <<~PROMPT
    あなたはAWSセキュリティレビュー担当者です。

    CloudFormationとCheckovの結果をレビューし結果を日本語で出力してください。
    各findingには、問題が発生したテンプレートの行範囲(line_range)を含めてください。
    Checkov結果のfile_line_rangeを参照してください。

    # CloudFormation

    #{template}

    # Checkov結果

    #{failed_checks}
  PROMPT
end

# Structured Outputで使用するJSONスキーマを返す。
# モデルの出力がこのスキーマに強制的に準拠するため、
# 後処理でのJSON抽出・バリデーションが不要になる。
def report_schema
  {
    type: "object",
    properties: {
      summary: { type: "string", description: "全体のサマリ" },
      findings: {
        type: "array",
        items: {
          type: "object",
          properties: {
            severity: { type: "string", enum: ["Critical", "High", "Medium", "Low"] },
            issue: { type: "string", description: "問題点" },
            reason: { type: "string", description: "なぜ危険か" },
            attack_scenario: { type: "string", description: "攻撃シナリオ" },
            recommendation: { type: "string", description: "推奨修正" },
            line_range: {
              type: "array",
              items: { type: "integer" },
              description: "問題が発生したテンプレートの行範囲 [開始行, 終了行]"
            }
          },
          required: ["severity", "issue", "reason", "attack_scenario", "recommendation", "line_range"],
          additionalProperties: false
        }
      },
      overall_assessment: { type: "string", description: "総評" }
    },
    required: ["summary", "findings", "overall_assessment"],
    additionalProperties: false
  }.to_json
end

def generate_report(prompt)
  client =
    Aws::BedrockRuntime::Client.new

  response =
    client.converse(
      model_id: ENV.fetch("MODEL_ID"),
      messages: [
        {
          role: "user",
          content: [
            { text: prompt }
          ]
        }
      ],
      output_config: {
        text_format: {
          type: "json_schema",
          structure: {
            json_schema: {
              schema: report_schema,
              name: "security_review_report",
              description: "IaCセキュリティレビューレポート"
            }
          }
        }
      }
    )

  # Structured Outputにより、レスポンスは必ずスキーマ準拠のJSON
  raw_text = response.output.message.content[0].text

  # 整形して返す
  parsed = JSON.parse(raw_text)
  JSON.pretty_generate(parsed)
end

JSONの定義は report_schema メソッドで実装しています。これを使ってconverseメソッドにてoutput_configを指定することでstructured outputを実装することができます。

まとめ

生成AIを使ったシステムでは、最終的に人が読むからといってMarkdownを出力することが最適とは限りません。むしろ、後続処理まで考えるとJSONで受け取り、画面表示の直前でMarkdownやHTMLへ変換する方が扱いやすいケースが多いです。

今回Structured Outputへ変更したことで、今後の実装に幅が広がると考えています。生成AIを「チャットツール」として使うだけでなく、「システムの部品」として組み込む場合には、Structured Outputは非常に有効な機能だと感じています。
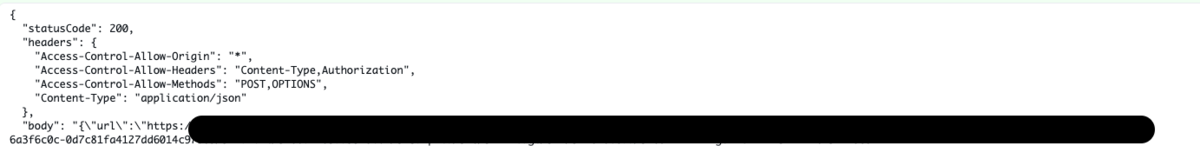
署名付きURLを活用した大容量ファイルの安全なアップロード手法(Rubyサンプル付き)

はじめに

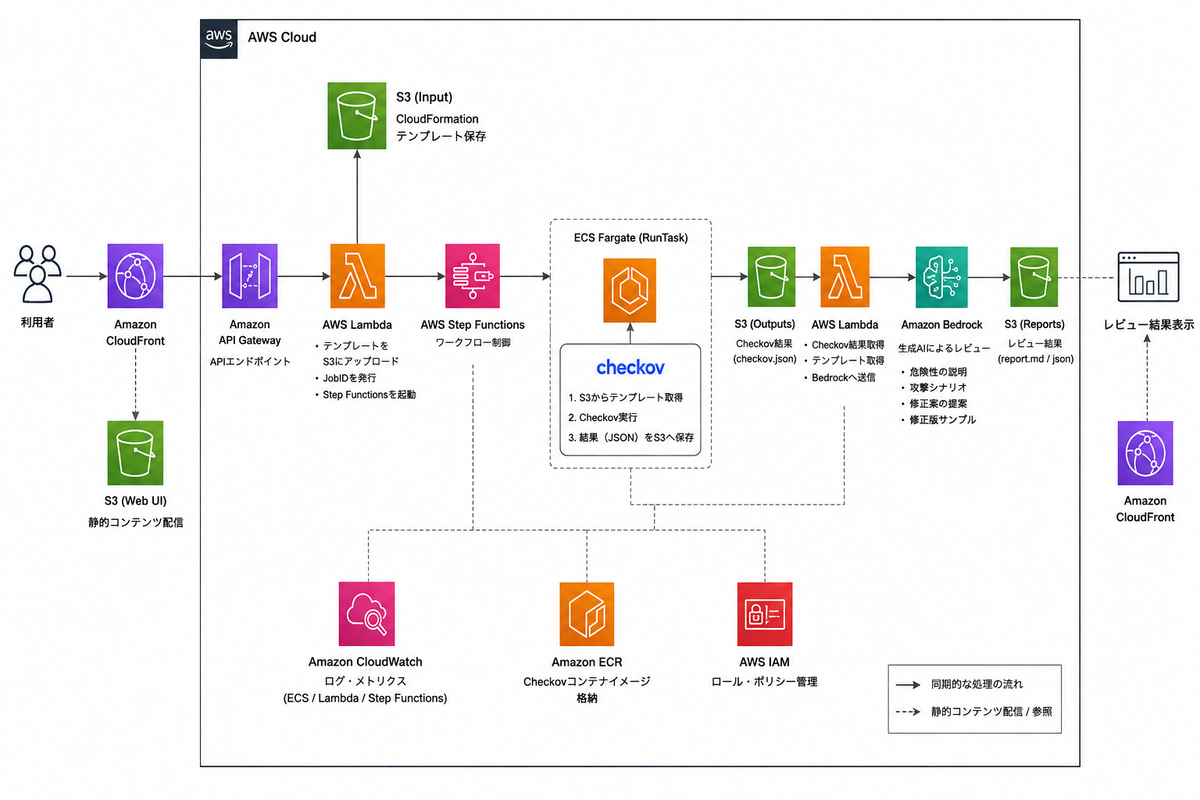
API Gateway経由でS3にファイルをアップロードする処理は一見すると単純そうに見えます。しかし少しサイズの大きいファイルを扱い始めるとAPI GatewayやLambdaの制限に引っかかることがあります。先日より実装を進めているIaCコードレビューシステムにおいてもファイルをアップロードする処理があります。下の構成図の左側の部分です。

その部分の実装を進めていくときに以下の課題が気になりました。

  • API Gatewayのペイロードサイズ制限(10MB)
  • Lambdaのメモリ、実行時間、ペイロード制限

このままAPI Gateway → Lambda経由でアップロードすると、ファイルサイズが10MBを超えた時点で受け付けられません。また、Lambdaに一度にファイルを読み込ませるため、メモリ消費や実行時間も無駄になります。

今回はこれを解決する手法を紹介します。

署名付きURL

実装のキーとなるのが、S3の署名付きURLです。

docs.aws.amazon.com

署名付きURLを使うと、クライアントは一定時間だけ有効なURLを使ってS3へ直接アップロードできます。つまり、ファイルはLambdaを経由しません。

これをLambdaで実装してみます。Lambdaの役割は非常にシンプルです。

  1. アップロード先のS3キーを決める
  2. 署名付きURLを生成する
  3. URLをクライアントへ返す

実装(Ruby)

コード全体は以下のとおり(Ruby)。

require 'json'
require 'securerandom'
require 'aws-sdk-s3'

def lambda_handler(event:, context:)
    job_id = SecureRandom.uuid

    bucket_name = 'my_s3_bucket_name'
    s3_key = "users/user001/#{job_id}/template.yaml"

    s3_client = Aws::S3::Client.new
    signer = Aws::S3::Presigner.new(client: s3_client)
    presigned_url = signer.presigned_url(
        :put_object,
        bucket: bucket_name,
        key: s3_key,
        expires_in: 300,
        content_type: 'application/x-yaml'
    )
    {
        statusCode: 200,
        headers: {
            'Access-Control-Allow-Origin' => '*',
            'Access-Control-Allow-Headers' => 'Content-Type,Authorization',
            'Access-Control-Allow-Methods' => 'POST,OPTIONS',
            'Content-Type' => 'application/json'
        },
        body: JSON.generate({
            url: presigned_url,
            job_id: job_id
        })
    }
end

ポイントはsigner.presigned_urlです。今回は上記のIaCコードレビューシステムで使うことを前提としているので、content_typeapplication/x-yamlとしています。また、有効期限としてexpires_in300(5分)としています。

このLambda関数を実行すると、署名付きURLが取得できます。

動作確認

実際に取得したURLを使ってアップロードをしてみます。クライアント側で行うことはPUTリクエストを送るだけです。

上記で得られた署名付きURLを変数urlに格納し、curlを以下のように実行するとS3にアップロードできます。

$ curl -X PUT -H 'Content-Type: application/x-yaml' --upload-file template.yaml $url

今回は署名生成時にcontent_typeも署名対象に含めています。そのため、アップロード時にも同じContent-Typeを指定しないと署名が一致せず、SignatureDoesNotMatchになります。

<Error><Code>SignatureDoesNotMatch</Code><Message>The request signature we calculated does not match the signature you provided. Check your key and signing method.</Message>

なお、S3をパブリックにする必要はなく、Lambdaに対してはS3に対するput object権限を付与してあげればよいです。

ちなみに、5分経過後は以下のメッセージが返ってきてアップロードできませんでした。

<Error><Code>AccessDenied</Code><Message>Request has expired</Message>

まとめ

今回はS3の署名付きURLを使ったアップロード方法を紹介しました。

この方法を使うことで

  • API Gatewayの10MB制限を回避できる
  • Lambdaでファイルを扱わなくてよい
  • S3を公開する必要もない

といったメリットがあります。ファイルアップロード機能を実装する場合は、まずこの構成を検討するとよいでしょう。

Checkovと生成AIによるIaCコードのレビューシステム構築2

はじめに

先日より、「Checkovと生成AIによるIaCコードのレビューシステム構築」と題してレビューシステムを作っています。

miyohide.hatenablog.com

今回は、Checkovの解析結果をもとに生成AIを使ってレビューすることをしてみました。構成図で言うと、右側のLambdaに該当します。

Lambdaの実装

はじめに実装から。今回はRubyで実装しました。

require "json"
require "aws-sdk-s3"
require "aws-sdk-bedrockruntime"

def lambda_handler(event:, context:)
  s3 = Aws::S3::Client.new

  template = s3.get_object(
    bucket: event["inputBucket"],
    key: event["templateKey"]
  ).body.read

  checkov = s3.get_object(
    bucket: event["outputBucket"],
    key: event["checkovResultKey"]
  ).body.read

  prompt = build_prompt(
    template: template,
    checkov: checkov
  )

  report = generate_report(prompt)

  report_key = "#{event['jobId']}/report.md"

  s3.put_object(
    bucket: event["outputBucket"],
    key: report_key,
    body: report,
    content_type: "text/markdown"
  )

  {
    reportKey: report_key
  }
end

def summarize_checkov(json_text)
  data = JSON.parse(json_text)

  failed =
    data
      .dig("results", "failed_checks") || []

  failed.map do |c|
    {
      id: c["check_id"],
      name: c["check_name"],
      resource: c["resource"]
    }
  end
end

def build_prompt(template:, checkov:)
  failed_checks =
    JSON.pretty_generate(
      summarize_checkov(checkov)
    )

  <<~PROMPT
    あなたはAWSセキュリティレビュー担当者です。

    CloudFormationとCheckovの結果をレビューしてください。

    # CloudFormation

    #{template}

    # Checkov結果

    #{failed_checks}

    # 出力形式

    以下のMarkdown形式で出力してください。

    # サマリ

    # Critical

    # High

    # Medium

    # Low

    # 指摘事項

    問題点:
    なぜ危険か:
    攻撃シナリオ:
    推奨修正:

    # 総評
  PROMPT
end

def generate_report(prompt)
  client =
    Aws::BedrockRuntime::Client.new

  response =
    client.converse(
      model_id:
        ENV.fetch("MODEL_ID"),

      messages: [
        {
          role: "user",
          content: [
            {
              text: prompt
            }
          ]
        }
      ]
    )

  response
    .output
    .message
    .content[0]
    .text
end

ポイントは、checkovのデータのうちfailed_checksの部分だけを渡していることです。これにより、LLMのトークンを節約することができます。

プロンプトは色々と試行錯誤する必要があるかと思いますが、まずはこんな感じで。LLMのモデルは環境変数MODEL_IDを指定することで切り替えられるようにはしていますが、合わせて指定するmessagesの中身がモデルごとに異なるのであまり汎用性は高くないかなとも思います。

レポート例

とりあえずということで、Amazon Nova 2 Liteを使ってレポートを作成してみたのが以下のものです。

# セキュリティレビュー結果

## サマリ

| カテゴリ | 件数 |
| --- | --- |
| Critical | 5 |
| High | 8 |
| Medium | 9 |
| Low | 7 |
| 合計 | 29 |

## Critical

1. **CKV_AWS_260**: Ensure no security groups allow ingress from 0.0.0.0:0 to port 80
   - リソース: `AWS::EC2::SecurityGroup.WebTierSecurityGroup`
   - 問題点: WebTierセキュリティグループでHTTP(ポート80)が全世界(0.0.0.0/0)から許可されている
   - なぜ危険か: 全世界からHTTPアクセスが可能となり、攻撃者にサービスへのアクセスを許可している
   - 攻撃シナリオ:攻撃者は任意の悪意のあるリクエストを送信し、サービスを攻撃または利用できる
   - 推奨修正: HTTPSに変更するか、許可するIP範囲を制限する

2. **CKV_AWS_24**: Ensure no security groups allow ingress from 0.0.0.0:0 to port 22
   - リソース: `AWS::EC2::SecurityGroup.WebTierSecurityGroup`
   - 問題点: WebTierセキュリティグループでSSH(ポート22)が全世界(0.0.0.0/0)から許可されている
   - なぜ危険か: 全世界からSSHアクセスが可能となり、サーバーが攻撃者にハイジャックされるリスクがある
   - 攻撃シナリオ:攻撃者はSSHを介してサーバーにアクセスし、システムを制御または破壊できる
   - 推奨修正: SSHアクセスを信頼されたIP範囲に制限するか、バストン・ホストを使用する
(省略)

生成AIを使って問題点や危険性、推奨修正が捕捉されているのが確認できます。推奨修正の中でバストン・ホストはおそらくBastionのことを言いたかったかと思います。こう言うのはモデルの性能の差が出るのではないかと考えています。

ただ、とりあえずの動作確認としては問題ないでしょう。

今後

簡単な動作確認はできましたので、次のステップに進みたいと思います。

Checkovと生成AIによるIaCコードのレビューシステム構築1

はじめに

仕事でシステムレビューや設計レビューをやることがあるのですが、レビューにはいくつかの課題があります。

  • その日によって観点がぶれることがある
  • IAMやネットワークなど確認すべき項目が多い
  • 単純な設定ミスの確認に時間を取られる
  • 人手によるレビューでは見落としが発生する

そこで今回は、CloudFormationテンプレートやCDKをアップロードすると、

  1. Checkovによる静的解析
  2. 生成AIによるレビュー
  3. レポート出力

を行うサービスをAWS上で構築してみることにしました。

今回は第一弾として、Checkovによる静的解析基盤と生成AIによるレポート生成機能の実装について紹介します。

全体構成

今回構築しようとしているシステムの全体像(案)は以下の通りです。後日、設計や実装を進めると全体像は変わる可能性がありますが、今のところこんな感じです。

レビュー処理は数十秒程度かかる可能性があるため、Step Functionsを利用した非同期処理として実装しています。

Checkovによる静的解析

CloudFormationのレビューを行う前に、まずは静的解析ツールであるCheckovを実行します。

CheckovはAWS向けのIaCツールであるCloudFormation以外にもTerraformやAzure向けのBiCepなどIaC向けの静的解析ツールで、以下のような問題を検出できます。

  • Security Groupの全開放
  • S3バケットの公開設定
  • 暗号化設定漏れ
  • IAM権限の過剰付与
  • ログ取得設定漏れ

今回はECS Fargate上でCheckovを実行する構成としました。

ECS RunTaskを採用した理由

当初はLambdaで実装することも考えました。

しかしCheckovはPythonベースのツールであり、将来的には以下も実行したいと考えています。

  • cfn-lintやcfn-nagの適用
  • 実行時間が15分を超えてしまうかもしれない

コンテナベースで実行できるECS Fargateを選択しました。

処理フローは非常にシンプルです。

Step Functions
    ↓
ECS RunTask
    ↓
S3からテンプレート取得
    ↓
Checkov実行
    ↓
結果をS3へ保存

Checkov実行コンテナ

Dockerfileは以下のようなシンプルな構成です。

FROM public.ecr.aws/docker/library/python:3.14-slim

RUN pip install checkov boto3

WORKDIR /app

COPY app.py .

CMD ["python", "app.py"]

コンテナ起動時にS3からCloudFormationテンプレートを取得し、Checkovを実行します。

import json
import os
import subprocess

import boto3

s3 = boto3.client("s3")

bucket = os.environ["INPUT_BUCKET"]
key = os.environ["INPUT_KEY"]

local_file = "/tmp/template.yaml"

s3.download_file(
    bucket,
    key,
    local_file
)

subprocess.run([
    "checkov",
    "-f",
    local_file,
    "-o",
    "json",
    "--output-file-path",
    "/tmp/results"
])

s3.upload_file(
    "/tmp/results/results_json.json",
    bucket,
    f"results/{key}.json"
)

結果はJSON形式でS3へ保存しています。

生成AIによるレビュー

Checkovの結果だけでも有用ですが、

      "failed_checks":[
         {
            "check_id":"CKV_AWS_260",
            "bc_check_id":"BC_AWS_NETWORKING_67",
            "check_name":"Ensure no security groups allow ingress from 0.0.0.0:0 to port 80",
            "check_result":{
               "result":"FAILED",
               "evaluated_keys":[
                  "Properties/SecurityGroupIngress"
               ]
            },
            (以下略)
         },

のような出力だけでは利用者が問題を理解しづらい場合があります。そこでAmazon Bedrockを利用してレビュー文章を生成することにしました。

レビュー用Lambdaでは以下を実施することを考えています。

  1. CloudFormation取得
  2. Checkov結果取得
  3. プロンプト生成
  4. Bedrock呼び出し
  5. Markdownレポート保存

プロンプト設計

生成AIにはCloudFormation全文とCheckov結果を渡します。

特に重要なのは、単に問題を列挙させるのではなく、

  • なぜ危険なのか
  • どのような攻撃シナリオが考えられるか
  • どのように修正すべきか

を説明させることです。具体的にどのように実装するかについては、次回以降のブログで記す予定です。

おわりに

今回はCloudFormationレビューサービスの第一歩として、

  • Checkovによる静的解析
  • ECS RunTaskによる実行基盤

を実装しました。

次回は生成AIを使った指摘の深掘りや修正案の提案について試してみたいと思います。