AWS Certified CloudOps Engineer - Associate合格体験記

はじめに

先日、AWS Certified CloudOps Engineer - Associateを受験し、合格できました。

ここでは試験勉強と受験に際してやったことを記します。

試験勉強

まず、試験勉強ですが、今回は(今回も)生成AIを積極的に活用しました。

最初に試験ガイドを生成AIに読み込ませて、必要な知識などを整理したMarkdownとして出力させました。CloudOps Engineer - Associateの試験ガイドは以下です。

docs.aws.amazon.com

出力されたMarkdownを読み込みながら、ちょっと自分自身で記憶や知識が曖昧だなと感じたところは追記を依頼する、という進め方をしています。たとえばEC2のプレイスメントグループやS3のストレージクラスといったあたりは、改めて整理してもらうことで理解が深まりました。

加えてUdemyも活用しました。ちょっと前までは少し高度なものは英語のものしかなかったのですが、今は日本語のものも多くあります。私が活用したのは以下のコースです。

AWS認定CloudOps Engineer Associate(SOA-C03)試験 対策トレーニング

こちらもすべてを真面目に見るのではなく、あまり触れてこなかったところや、ちょっと記憶が怪しいところを中心に視聴しました。

受験

試験はいつものとおり近くのテストセンターで朝イチの9時半から受験しました。受験に関しては、鉄板ですが以下のブログの内容をもとに受験しています。

AWS 認定試験を受けるときのコツ | Amazon Web Services ブログ

個人的な運用は毎回同じで、まず曖昧なところには見直しフラグをつけながら回答を進めていきます。結果的に今回はフラグが7つついた状態で一通り解き終わり、この段階で残り時間は60分でした。その後、改めてすべての問題を見直し。フラグの数は9問に増えたのですが、自分なりの合格基準である8割は超えているなと考え、試験時間を30分残して終了しました。

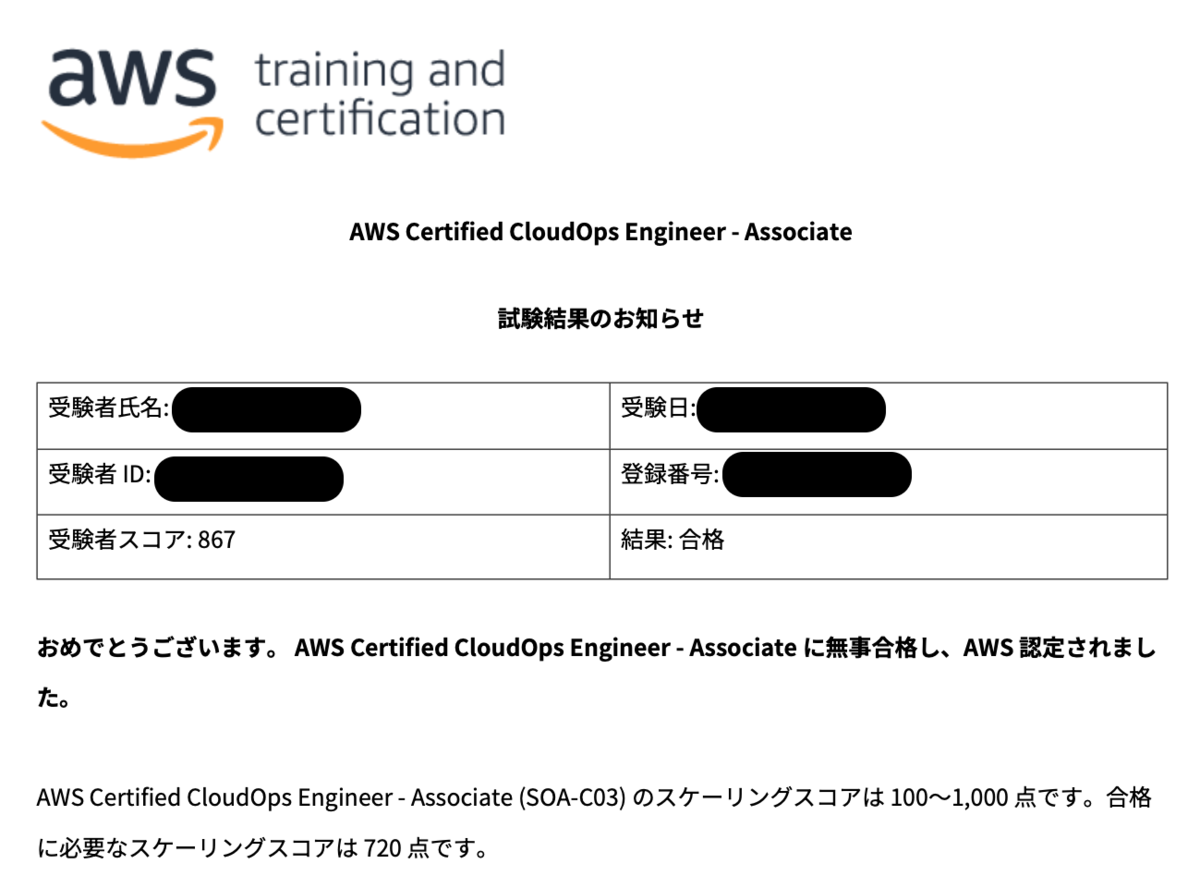
結果は例によってその日の夜9時前に届き、無事合格でした。

以上がAWS Certified CloudOps Engineer - Associateの合格体験記です。

EOLを乗り越えるためにBedrockモデルのライフサイクルを理解する(2026年10月10日版)

はじめに

日々、新しいモデルがリリースされる一方で、古いモデルはどんどんEOLとなります。Amazon Bedrock(以下、Bedrock)でも同様で、モデルにはEOLがあり、思いの外早くEOLになります。これまでのオンプレミスのミドルウェアやOSのように「一度選んだら5年使う」という感覚でモデルを選ぶと、思ったより早く移行作業に追われることになります。

この記事では、BedrockのLLMのライフサイクル(提供開始から提供終了までの流れ)について、実際のモデルの例を交えながら整理します。

なお、この記述は2026年10月10日時点の内容に基づいて書いています。

結論

はじめに結論です。

  • Bedrockのモデルは、提供開始から概ね半年ほどでLegacy(レガシー)になり、その約6ヶ月後にEOL(End-of-Life、提供終了)を迎えます
  • 最近のモデルでは、提供開始からEOLまでは1年半前後です。2年を超えて使えるケースはほとんど期待できません
  • ライフサイクルポリシーは過去に何度か変更されています。最新のポリシーでは、多くのモデルでEOLの6ヶ月前にLegacyになります
  • EOLが近づくと料金が上がる仕組み(Public extended access)があります
  • 個々のモデルのEOLは、公式ドキュメントのモデルカードで確認します

モデルの3つの状態

Bedrockのモデルは、次の3つの状態のいずれかにあります。

状態 説明
Active モデル提供元が継続的にメンテナンスしている状態
Legacy 提供終了が予定されている状態。既存ユーザーは引き続き利用できるが、移行が推奨される
EOL 提供終了。全リージョンから削除され、リクエストは失敗する

Legacyになると、次のような制約がかかります。

  • 新規の利用者はそのモデルを使い始められない
  • 既存の利用者でも、15日以上呼び出しがないとアクセスできなくなる場合がある
  • 新しいProvisioned Throughputを作成できない
  • 新しいファインチューニングジョブを作成できない

また、EOLになっても自動で新しいモデルに切り替わることはありません。アプリケーション側でモデルIDを書き換える必要があります。

実際のモデルはどれくらい使えたのか

公式ドキュメントのモデルカードと「Model lifecycle (Legacy)」ページから、いくつかのモデルについて提供開始日とEOL日を生成AIを使って整理してみました。

モデル Bedrockでの提供開始日 Legacy日 EOL日 提供期間
Claude Sonnet 4 2025年5月23日 2026年4月14日 2026年10月14日 約1年5ヶ月
Claude Opus 4.1 2025年8月5日 2026年7月8日 2027年1月8日 約1年5ヶ月
Claude Sonnet 4.5 2025年9月30日 2026年10月8日 2027年4月8日 約1年6ヶ月
Cohere Command R 2024年8月 2026年2月19日 2026年8月19日 約2年
Claude 3 Haiku 2024年3月13日 2026年3月10日 2026年9月10日 約2年6ヶ月

Claude 4世代のモデルを見ると、傾向がはっきりしています。

  • 提供開始から約11〜12ヶ月でLegacyになる
  • Legacyになってから6ヶ月でEOLになる
  • 結果として、提供期間は1年半前後になる

一方で、Claude 3 HaikuやCommand Rのように2年以上提供されたモデルもあります。ただし、これらはClaude 3世代など比較的古い時期のモデルです。モデルの世代交代が速くなっている最近の状況を考えると、「長くても2年弱」と見積もっておくのが安全です。

ライフサイクルポリシーの変遷

ライフサイクルポリシーは、これまでに何度か変更されています。

1. 最低12ヶ月の提供保証+6ヶ月のLegacy期間

もともとのポリシーでは、次の2点が約束されていました。

  • 提供開始から少なくとも12ヶ月はEOLにならない
  • EOLの少なくとも6ヶ月前にLegacyになり、通知される

2. Public extended access(料金が上がる期間)の追加

公式ページは以下をご確認ください。

docs.aws.amazon.com

EOL日が2026年2月1日以降のモデルについては、Legacy期間の中に「Public extended access」というフェーズが追加されました。

  • Legacyになってから最低3ヶ月後に、Public extended accessに入る
  • Public extended accessの期間は、EOLまで最低3ヶ月
  • この期間中は、モデル提供元が設定した高い料金になる可能性がある
  • Service Quotasでのクォータ引き上げ申請も、基本的に承認されない

つまり、6ヶ月のLegacy期間のうち、後半の3ヶ月は料金が上がる可能性があります。たとえばClaude Sonnet 4.5の場合は、次のスケジュールです。

2025/09/30  提供開始
2026/10/08  Legacy
2027/01/08  Public extended access 開始(料金改定の可能性あり)
2027/04/08  EOL

なお、料金改定はLegacyの通知時点で予告されるため、遡って請求額が上がることはないとのこと。また、提供元と個別の料金契約を結んでいる場合や、Provisioned Throughputを使っている場合は、既存の料金条件が適用されるそうです。

詳細は以下のブログをご確認ください。

aws.amazon.com

3. 2026年9月7日以降に提供開始されたモデル向けの新ポリシー

公式ページは以下をご確認ください。

docs.aws.amazon.com

2026年9月7日以降に提供開始されたモデルには、新しいライフサイクルポリシーが適用されます。それ以前のモデルは、従来のポリシー(「Model lifecycle (Legacy)」ページ)が引き続き適用されます。

新ポリシーでは、一律の「12ヶ月保証」ではなく、モデルカードに次の2つが記載されるようになりました。

  • EOL no sooner than:この日付より前にEOLになることはない
  • Legacy period:EOL前の通知期間。6ヶ月と45日の2種類があり、ほとんどのモデルは6ヶ月

たとえば、2026年9月22日に提供開始されたClaude Opus 5.5のモデルカードには、次のように記載されています。

  • EOL no sooner than:2027年9月22日
  • Legacy period:6 months

Legacy期間が45日のモデルもあり得るので、モデルごとの確認がこれまで以上に重要になっています。

なお、新しいポリシーページにはPublic extended accessや料金が上がることに関する記述を見つけることができませんでした。

EOLはモデルカードで確認する

個々のモデルのEOLは、公式ドキュメントの各モデルのモデルカードで確認します。モデルカードには、次のような情報が載っています。

  • Model launch date(提供開始日)
  • EOL no sooner than(この日より前にはEOLにならない日付)
  • Legacy period(Legacy期間)
  • Model lifecycle policy(適用されるライフサイクルポリシー)
  • Model EOL date(EOL日。Legacyになった時点で記載される)
  • Model lifecycle(現在の状態)

注意点として、Bedrockでのライフサイクルの日付は、Anthropicなどのモデル提供元が公表している日付とは異なる場合があります。Bedrockで使う場合は、モデルカードに記載された日付だけが有効です。

また、Legacyの状態はリージョンによって異なる場合があります。自分が使っているリージョンでの状態は、APIで確認できます。

# 東京リージョンでのモデルの状態を確認する
aws bedrock get-foundation-model \
  --model-identifier anthropic.claude-sonnet-4-5-20250929-v1:0 \
  --region ap-northeast-1 \
  --query 'modelDetails.modelLifecycle'

運用上の対策

ここまでの内容を踏まえると、Bedrockを使ったアプリケーションでは次のような対策をしておくと安心です。

  1. モデルIDをコードに直接書かず、設定ファイルや環境変数で切り替えられるようにする
  2. 新しいモデルに切り替えたときの品質を確認できる評価用データとテストを用意しておく
  3. AWS Health Dashboardの通知や、アカウントの代替連絡先(Alternate contacts)を設定し、Legacyの通知を見逃さないようにする
  4. Legacyの通知が来たら、Public extended accessに入る前(Legacyになってから3ヶ月以内)に移行を終える計画を立てる
  5. システムの企画段階で、「1年に1回はモデルの移行作業が発生する」前提で工数を見積もっておく

まとめ

  • BedrockのLLMは、提供開始から約半年でLegacyになり、その6ヶ月後にEOLを迎えるのが最近の傾向です
  • Claude 4世代のモデルでは、提供期間はいずれも1年半前後でした
  • EOLが近づくとPublic extended accessに入り、料金が上がる可能性があります
  • 2026年9月7日以降に提供開始されたモデルは新しいポリシーが適用され、モデルカードに「EOL no sooner than」とLegacy期間が明記されます
  • 使っているモデルのEOLは、必ずモデルカードで確認しましょう

参考資料

Amazon Bedrock AgentCore RuntimeでNode.jsアプリのObservability設定方法

はじめに

Amazon Bedrock AgentCore Runtime上でAIエージェントを動かす場合、実際にどのように処理が実行されているのかを確認するために、Observabilityは重要です。

特に生成AIアプリケーションでは、

  • エージェントのセッション数
  • トレース
  • LLMの呼び出し
  • 入出力トークン
  • 実行時間
  • ログ

などを確認できると、開発時のデバッグだけでなく、運用時の監視にも役立ちます。

今回は、Node.js + Strands Agentsで作成したAIエージェントをAmazon Bedrock AgentCore Runtime上で動かし、AWS Distro for OpenTelemetry(ADOT)の自動計装を利用して各種データを取得してみました。

結論からいうと、アプリケーション側にOpenTelemetry用のコードを追加することなく、AgentCore RuntimeのトレースやメトリクスをCloudWatchから確認できました。

ただし、いくつかハマったポイントもありました。

特に重要だったのが、以下2点です。

  • アプリケーションのエントリーポイントを opentelemetry-instrument 経由で起動すること
  • UNIFIED_TRACES_DESTINATION_ENABLED=true を設定すること

この記事では、実際に設定した内容と、CloudWatch上でどのように確認できたのかを紹介します。

今回の構成

今回作成したのは、Node.jsで実装したStrands Agentsのエージェントです。

大まかな構成は次のようになります。

                    ┌─────────────────────────┐
                    │ Amazon Bedrock          │
                    │ AgentCore Runtime       │
                    │                         │
                    │ Node.js                 │
                    │ Strands Agents          │
                    └───────────┬─────────────┘
                                │
                         OpenTelemetry
                                │
                                ▼
                    ┌─────────────────────────┐
                    │ CloudWatch              │
                    │                         │
                    │ Logs / Spans / Metrics  │
                    │                         │
                    │ GenAI Observability     │
                    └─────────────────────────┘

アプリケーション自体はstrands-agentsを利用しています。

Observabilityについては、AWS Distro for OpenTelemetryのNode.js自動計装を利用しました。

今回利用したパッケージは以下です。

{
  "dependencies": {
    "@aws/aws-distro-opentelemetry-node-autoinstrumentation": "^0.13.0"
  }
}

OpenTelemetryの自動計装を利用する

今回のポイントの一つが、OpenTelemetryのコードをアプリケーションに直接追加しなかったことです。@aws/aws-distro-opentelemetry-node-autoinstrumentationを利用して自動計装を行なったため、AgentCore Runtimeの設定にてエージェント エントリーポイントを以下のように設定しました。

opentelemetry-instrument, dist/app.js

最初にopentelemetry-instrumentを指定するのがポイントです。
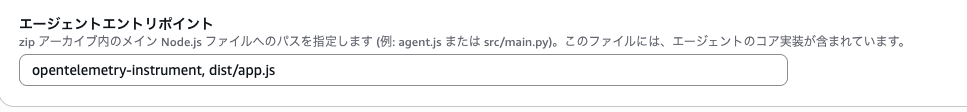
ここは非常にシンプルでした。

AgentCore Runtimeの環境変数

AgentCore Runtimeに、Observabilityに関連する環境変数を設定します。今回設定したものとしてUNIFIED_TRACES_DESTINATION_ENABLED=trueの設定が必要でした。

最初、この環境変数を設定していない状態でもRuntime自体は正常に動作していました。しかし、期待していたトレース情報がCloudWatch Logsのspansログストリームに出力されませんでした。

そこで、UNIFIED_TRACES_DESTINATION_ENABLED=trueを設定してRuntimeを実行したところ、spansへの出力を確認できました。

CloudWatch Transaction Searchを有効化する

AgentCore RuntimeのObservabilityを確認するためには、CloudWatch側の設定も必要です。今回、CloudWatch Transaction Searchを有効化しました。設定方法は以下を確認してください。

docs.aws.amazon.com

IAMロール

IAMロールは以下のものを設定しています。logsやxrayあたりがポイントかと思います。

{
    "Version": "2012-10-17",
    "Statement": [
        {
            "Effect": "Allow",
            "Action": [
                "s3:GetObject",
                "s3:ListBucket"
            ],
            "Resource": [
                "arn:aws:s3:::バケット名",
                "arn:aws:s3:::バケット名/*"
            ]
        },
        {
            "Effect": "Allow",
            "Action": [
                "logs:CreateLogGroup",
                "logs:CreateLogStream",
                "logs:PutLogEvents",
                "logs:DescribeLogStreams",
                "logs:DescribeLogGroups",
                "logs:PutResourcePolicy"
            ],
            "Resource": "*"
        },
        {
            "Effect": "Allow",
            "Action": [
                "bedrock:InvokeModel",
                "bedrock:InvokeModelWithResponseStream"
            ],
            "Resource": "*"
        },
        {
            "Effect": "Allow",
            "Action": [
                "bedrock-agentcore:GetWorkloadAccessToken",
                "bedrock-agentcore:GetWorkloadAccessTokenForJWT",
                "bedrock-agentcore:GetWorkloadAccessTokenForUserId"
            ],
            "Resource": "*"
        },
        {
            "Effect": "Allow",
            "Action": [
                "xray:PutTraceSegments",
                "xray:PutTelemetryRecords",
                "xray:GetSamplingRules",
                "xray:GetSamplingTargets"
            ],
            "Resource": "*"
        },
        {
            "Effect": "Allow",
            "Action": "cloudwatch:PutMetricData",
            "Resource": "*",
            "Condition": {
                "StringEquals": {
                    "cloudwatch:namespace": "bedrock-agentcore"
                }
            }
        }
    ]
}

実際にRuntimeを呼び出してみる

設定が完了したら、実際にAgentCore Runtimeを呼び出します。すると、CloudWatch Logsには比較的すぐにログが出力されました。また、AgentCore Runtimeのロググループにはspansというログストリームがつくられ、こちらにもトレース情報が出力されることを確認できました。
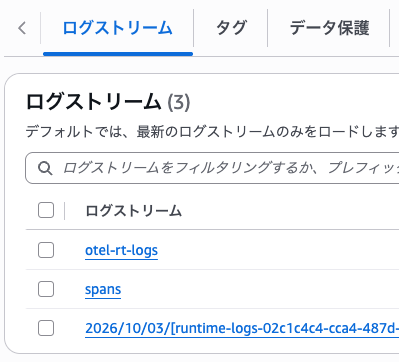
otel-rt-logsは少し遅れて出力された

一方で、少し注意が必要だったのがotel-rt-logsです。Runtimeを呼び出した直後には、otel-rt-logsの出力を確認できませんでした。しばらく待ってから確認したところ、Runtimeの呼び出しから5分程度経過した後に出力されることを確認しました。そのため、最初にObservabilityを試したときには、「設定が間違っていてotel-rt-logsが出てこないのでは?」と少し迷いました。しかし、実際には時間を置くことで出力されました。

CloudWatchの生成AIオブザーバビリティ

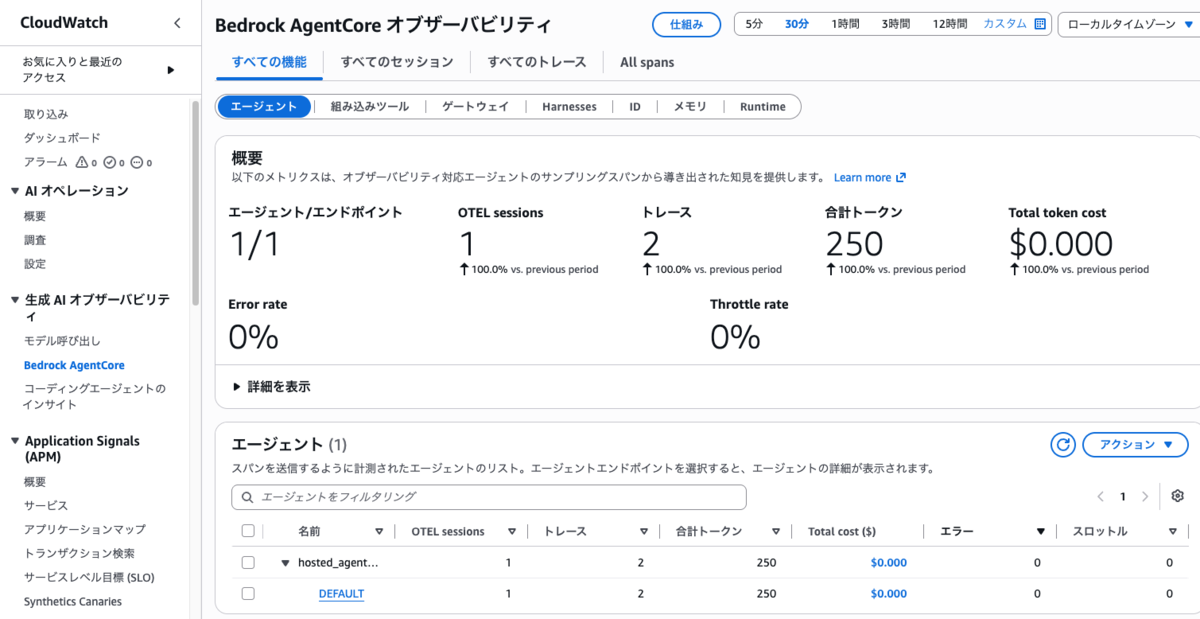
さらに面白かったのが、CloudWatchの生成AI向けObservability画面です。

CloudWatchには生成AIアプリケーション向けのObservability機能があり、その中にBedrock AgentCoreの項目があります。ここからAgentCore Runtimeの実行状況を確認できます。

画面上では、例えば、

  • セッション数
  • トレース
  • トークン使用量
  • 生成AIに関する各種メトリクス

などが整理されて表示されます。

OpenTelemetryのログを一つ一つ確認するよりも、こちらの画面を見ることでAgentCore上のエージェントがどのように実行されているのかを把握しやすくなっています。

特に生成AIアプリケーションでは、単純なCPU使用率やメモリ使用量だけではなく、

何回セッションが実行されたか
        ↓
どのようなトレースになっているか
        ↓
LLMをどれくらい呼び出したか
        ↓
どれくらいトークンを消費したか

といった情報が重要になるため、こうした情報をまとめて確認できるのは便利だと感じました。

今回ハマったポイント

今回の検証で特に注意したポイントをまとめます。

1. opentelemetry-instrumentを付けて起動する

単純に、

dist/app.js

と起動するのではなく、

opentelemetry-instrument dist/app.js

とします。

2. UNIFIED_TRACES_DESTINATION_ENABLEDを設定する

今回の検証では、

UNIFIED_TRACES_DESTINATION_ENABLED=true

を設定しました。

これを設定しなかった場合、期待していたspansへのトレース出力を確認できませんでした。Pythonに関する記述では設定不要と書かれているものも多かったのですが、Node.jsにてAgentCore RuntimeのObservabilityを試す場合には、この設定も確認したほうがよさそうです。

3. otel-rt-logsはすぐには出ない

Runtimeを呼び出しても、すべてのObservability情報が同じタイミングで出力されるわけではありませんでした。今回の環境では、通常のログやspansは比較的すぐに確認できましたが、otel-rt-logsは5分程度待つ必要がありました。そのため、「ログが出ない=設定ミス」とは限らない点には注意が必要です。

まとめ

今回は、Strands Agentsで作成したNode.jsアプリケーションをAmazon Bedrock AgentCore Runtime上で実行し、AWS Distro for OpenTelemetryの自動計装を利用してObservabilityを確認してみました。

今回のポイントは以下です。

項目 内容
エージェント Strands Agents
ランタイム Amazon Bedrock AgentCore Runtime
言語 Node.js
OpenTelemetry AWS Distro for OpenTelemetry
利用パッケージ @aws/aws-distro-opentelemetry-node-autoinstrumentation
バージョン 0.13.0
起動方法 opentelemetry-instrument, dist/app.js
AgentCore設定 UNIFIED_TRACES_DESTINATION_ENABLED=true
CloudWatch設定 Transaction Searchを有効化
確認できた情報 Logs / Spans / Metrics / GenAI Observability

特に印象的だったのは、アプリケーションコードにOpenTelemetryの処理を追加することなく、AgentCore RuntimeとCloudWatchのObservabilityを利用できたことです。また、CloudWatchの生成AIオブザーバビリティ画面では、AgentCore Runtimeについてセッション数やトレース、トークンなどが整理されて表示されるため、エージェントアプリケーションの状態を確認する用途にも使いやすいと感じました。

AgentCore Runtimeでエージェントを運用する場合、単に「動く」だけでなく、「何が起きているのかを観測できる」ことも重要になります。

今回の構成は、AgentCore Runtime上でNode.jsのAIエージェントを動かす際のObservabilityの第一歩として、かなり手軽な構成だと思います。
L2 Constructを活用したAgentCore Runtimeの構築

はじめに

Amazon Bedrock AgentCore Runtimeを使って、コンテナ化したAIエージェントをAWS上で実行する環境を作っています。この環境を作るのにCDKを使いたいのですが、少し前まではL2 Constructがありませんでした。当初は @aws-cdk/aws-bedrock-agentcore-alpha で提供されていましたが、5月ぐらいに安定版に移行したようです。

github.com

今回は、このL2 Constructである Runtime を使って、ECR上のコンテナイメージからAgentCore Runtimeを構築してみます。

実装

今回利用するのは、以下のConstructです。

docs.aws.amazon.com

AWS CDKのAPI Referenceでは、Runtime は AWS::BedrockAgentCore::Runtime をラップするConstructとして提供されています。agentRuntimeArtifact が必須ですが、実行ロール、ネットワーク、プロトコル、環境変数などをプロパティとして指定できます。

今回作る構成

今回の構成は次のようにします。

                  ┌────────────────────┐
                  │   Amazon ECR       │
                  │                    │
                  │ Agent Container    │
                  └─────────┬──────────┘
                            │
                            │ image tag
                            ▼
                  ┌────────────────────┐
                  │ AgentRuntimeArtifact│
                  └─────────┬──────────┘
                            │
                            ▼
                  ┌────────────────────┐
                  │ AgentCore Runtime  │
                  │                    │
                  │ Network: PUBLIC    │
                  │ Protocol: HTTP     │
                  │                    │
                  │ Strands Agent      │
                  └─────────┬──────────┘
                            │
                            │ IAM Role
                            ▼
                  ┌────────────────────┐
                  │ Bedrock            │
                  │ Nova 2 Lite etc.   │
                  └────────────────────┘

ECRリポジトリそのものはCDKから作成せず、既存のリポジトリを参照します。

CDKは、

  1. ECR上のコンテナイメージをAgentCore Runtimeから参照する
  2. AgentCore Runtimeの実行ロールを作る
  3. Bedrockを呼び出す権限を付与する
  4. AgentCore Runtimeを作成する

というところに限定します。

実装詳細

ECRリポジトリを参照する

今回はECRリポジトリをCDKで作成せず、既存のリポジトリを参照します。

const repository = ecr.Repository.fromRepositoryName(
  this,
  'AgentRepository',
  config.ecrRepoName,
)

AgentRuntimeArtifactを作る

次に、ECRのコンテナイメージをAgentCore Runtimeから利用するためのArtifactを作ります。

const agentRuntimeArtifact =
  AgentRuntimeArtifact.fromEcrRepository(
    repository,
    config.imageTag,
  )

AgentCore Runtimeの実行ロール

次に、AgentCore RuntimeからAWSサービスを呼び出すためのIAMロールを作成します。

const executionRole = new iam.Role(this, 'ExecutionRole', {
  roleName: config.roleName,
  description: 'Execution role for the Strands AgentCore Runtime',
  assumedBy: new iam.ServicePrincipal(
    'bedrock-agentcore.amazonaws.com',
    {
      conditions: {
        StringEquals: {
          'aws:SourceAccount': this.account,
        },
        ArnLike: {
          'aws:SourceArn':
            `arn:${this.partition}:bedrock-agentcore:${this.region}:${this.account}:*`,
        },
      },
    },
  ),
})

ここではAgentCoreのサービスプリンシパルがこのRoleをAssumeできるようにしています。

AgentCore Runtime
       │
       │ AssumeRole
       ▼
Execution Role

また、単純にサービスプリンシパルだけを信頼するのではなく、

aws:SourceAccount
aws:SourceArn

による条件も設定しています。いわゆるConfused Deputy対策です。

Bedrockモデル呼び出し権限

今回のエージェントはBedrockのモデルを呼び出すため、Execution Roleに以下の権限を追加します。

executionRole.addToPolicy(
  new iam.PolicyStatement({
    sid: 'InvokeBedrockModel',
    effect: iam.Effect.ALLOW,
    actions: [
      'bedrock:InvokeModel',
      'bedrock:InvokeModelWithResponseStream',
    ],
    resources: [
      `arn:${this.partition}:bedrock:*::foundation-model/*`,
      `arn:${this.partition}:bedrock:${this.region}:${this.account}:inference-profile/*`,
    ],
  }),
)

ここでは、foundation-modelとinference-profileの両方を対象にしています。これは、例えばモデルIDとしてクロスリージョン推論プロファイルを利用するケースを想定しているためです。

Runtimeを作る

ここまで準備できたら、AgentCore Runtimeを作成します。

const runtime = new Runtime(this, 'AgentRuntime', {
  runtimeName: config.runtimeName,
  agentRuntimeArtifact,
  executionRole,

  networkConfiguration:
    RuntimeNetworkConfiguration.usingPublicNetwork(),

  protocolConfiguration: ProtocolType.HTTP,

  environmentVariables: {
    MODEL_ID: config.modelId,
    AWS_REGION: config.awsRegion,
    MAX_TOKENS: config.maxTokens,
  },

  lifecycleConfiguration: {
    idleRuntimeSessionTimeout: Duration.minutes(3),
  },
})

これで、AWS::BedrockAgentCore::RuntimeをCDKから作成できます。

環境変数をRuntimeに渡す

AgentCore Runtimeのコンテナには環境変数を渡せます。

今回の例では、

environmentVariables: {
  MODEL_ID: config.modelId,
  AWS_REGION: config.awsRegion,
  MAX_TOKENS: config.maxTokens,
}

としています。

idleRuntimeSessionTimeoutを設定する

今回もう一つ指定しているのが、

lifecycleConfiguration: {
  idleRuntimeSessionTimeout: Duration.minutes(3),
},

です。AgentCore Runtimeではセッションがアイドル状態になった場合のタイムアウトを設定できます。2026年9月時点ではこのタイムアウトをコンソールマネジメントで設定できませんでした。これを設定するためにCDKを使っている面もあります。今回の検証環境では3分にしています。

CDKからAgentCore Runtimeを管理するメリット

今回実際にコード化してみると、AgentCore RuntimeをCDKで管理するメリットがいくつかあります。

1. Runtimeの設定をコードで管理できる

例えば、以下のものを全てコードとして管理できます。

  • runtimeName
  • networkConfiguration
  • protocolConfiguration
  • environmentVariables
  • lifecycleConfiguration
コンソールから設定する場合と比べて、環境差分を管理しやすくなります。

## 2. IAMも一緒に管理できる

AgentCore RuntimeだけでなくIAMも一緒に管理でき、必要なくなった時に削除もできるので、非常に使い勝手が良いです。

## 3. L2 Constructによる抽象化を利用できる

`CfnRuntime`を直接使うのではなく、`new Runtime(...)`と書くだけでAgentCore Runtimeを構築でき、かなりコンパクトに実装ができます。

## まとめ

今回はAWS CDKの `aws-cdk-lib/aws-bedrockagentcore` に提供されているL2 Constructの `Runtime` を使って、Amazon Bedrock AgentCore Runtimeを構築してみました。AgentCore Runtimeについては、Runtime本体だけでなく、

* IAM
* ECR
* Bedrock
* Lifecycle

など、周辺サービスとの関係が多くなります。そのため、これらをCDKでまとめて管理できるのはかなり便利です。一方で、L2 Constructに任せられる部分と、自分でIAM権限やアプリケーション設定を設計する部分の境界は理解しておいたほうがよさそうです。

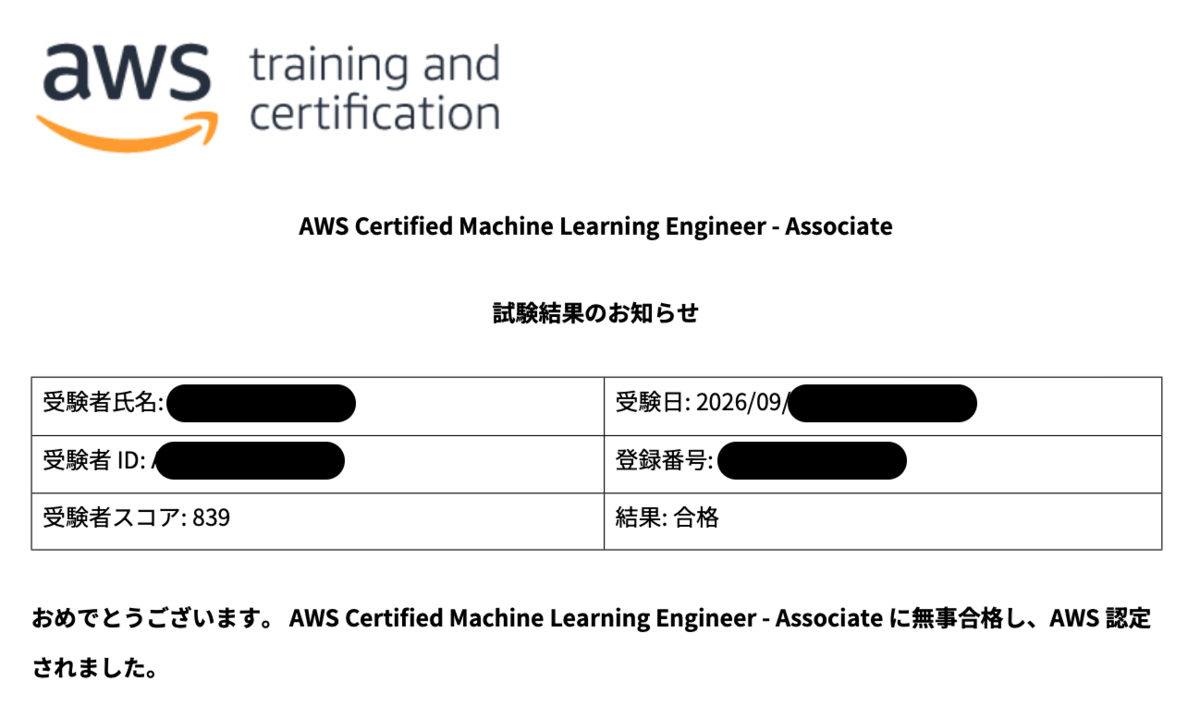
AWS Certified Machine Learning Engineer - Associate合格体験記

先日、AWS Certified Machine Learning Engineer - Associateの勉強法を以下に記しました。

miyohide.hatenablog.com

先日受験し、合格できました。

ここでは改めて試験勉強と受験に際してやったことを記します。

まず、試験勉強ですが主には勉強メモをMarkdownでまとめて書いています。

github.com

いわゆる隙間時間や試験前に目を通して知識の定着を図りました。

SageMakerはそんなに頻繁に触っていないので、ちょっと触ったほうが良いかなと思いワークショップを探してみました。良さそうなのは以下です。

  • SageMaker AI Workshop

catalog.us-east-1.prod.workshops.aws

  • Amazon SageMaker Workshop

catalog.us-east-1.prod.workshops.aws

実際にはちょっと時間が取れずにワークショップは未実施でした。MicrocredentialsであるAWS MLOps Demonstratedも受験しようかなと思っているので、その前にはワークショップは実施しておこうかと考えています。

skillbuilder.aws

実際の試験は近くのテストセンターで受験しました。受験に関しては、鉄板ですが以下のブログの内容をもとに受験しています。

aws.amazon.com

個人的には、合格ラインの目安を問題数の8割と考えており、わからない問題は見直しフラグをつける運用で受験するようにしています。一方で、問題の原文を見ることはほとんどなくなりました。だいぶ日本語の表現がこなれてきているように感じます。

以上がAWS Certified Machine Learning Engineer - Associateの合格体験記です。何かの参考になると幸いです。

AWS Certified Machine Learning Engineer - Associateの勉強法

今回、AWS Certified Machine Learning Engineer - Associateを受けることになり、その勉強をしています。

aws.amazon.com

以前、Machine Learning Specialtyを受験し合格したのですが、一年以上経っていることもあり結構忘れていることも多いです。

miyohide.hatenablog.com

そこで、あらためて知識の整理をすることにしました。

個人的に試験前には、試験ガイドを見ながらわからない用語とかをMarkdownで整理しています。今回のAWS Certified Machine Learning Engineer - Associateの試験ガイドは以下のもの。

docs.aws.amazon.com

個人的に自信がある分野についてはまとめず、あまり馴染みのないもの(今回の場合、SageMaker関係)を中心にまとめます。以下のような感じです。

github.com

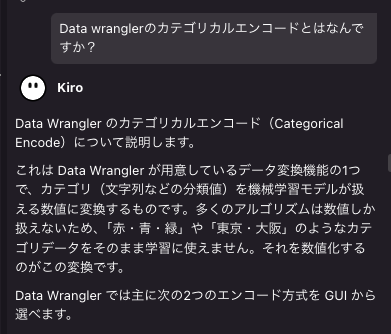
以前は手作業でちまちまキーワード検索をして手作業で追記していたのですが、今は生成AIを使うとかなり楽にメンテナンスできます。以下はKiroでの実行例。わからない用語を聞いています。

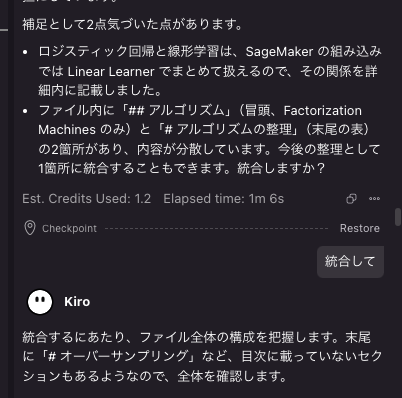
こういうメモを作るときに地味に面倒くさいのがメモ全体の整理です。これも生成AIに指示をするだけでOKです。

時間がある時にこのメモを見返したりして知識の定着を図ります。

あとはChatGPTにサンプル問題を作ってもらってたりしています。

これで試験に臨みたいと思います。

Lambda関数の成功・失敗をRubyのコードと共に理解する

はじめに

AWS Lambdaを利用していると、「Lambda関数が成功した」「Lambda関数が失敗した」という状態を扱うことがあります。例えば、CloudWatch Metricsの Errors や、Lambdaのイベントソースによるリトライを考える場合、何をもってLambda関数の「失敗」とするのかを正しく理解しておく必要があります。

今回は、RubyでLambda関数を実装し、Lambda関数単体でどのような場合に成功・失敗として扱われるのかを確認します。

Lambda関数の成功・失敗はHTTPステータスコードでは決まらない

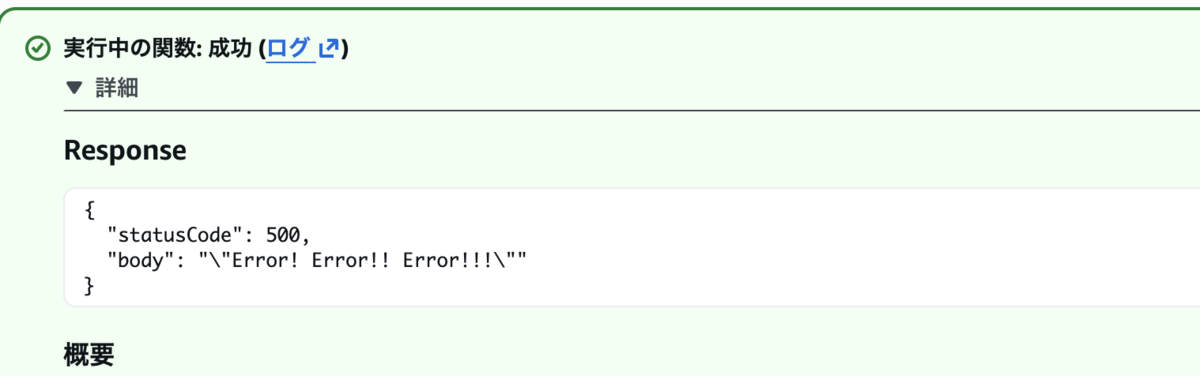
まずLambda関数が返す値と、Lambdaそのものの成功・失敗は別物であることを意識します。例えば、API GatewayなどからLambdaを呼び出す場合、次のようなレスポンスを返すLambdaを考えてみます。

def lambda_handler(event:, context:)
  {
    statusCode: 500,
    body: "Internal Server Error"
  }
end

これはLambda関数としては成功です。Lambdaのハンドラーは正常に値を返しており、例外も発生していません。これは、特にAPI GatewayとLambdaを組み合わせる場合に注意したいポイントです。

raise で例外を発生させる

次に、Rubyの raise を使って例外を発生させます。

def lambda_handler(event:, context:)
  raise "Something went wrong"
end

この場合は、Lambda関数は失敗になります。Lambdaのハンドラーから例外が伝播すると、Lambdaランタイムが関数エラーとして扱います。AWS公式ドキュメントでも、Lambdaのコードやランタイムでエラーが発生した場合、関数エラーとして扱われることが説明されています。

docs.aws.amazon.com

exit(0) は成功にならない

Rubyでは、プロセスを終了させるために exit を使うことができます。

例えば、

def lambda_handler(event:, context:)
  exit(0)
end

とします。一般的なプログラムでは、

exit(0) → 正常終了
exit(1) → 異常終了

という考え方をします。しかし、Lambdaではこの考え方をそのまま適用することはできません。

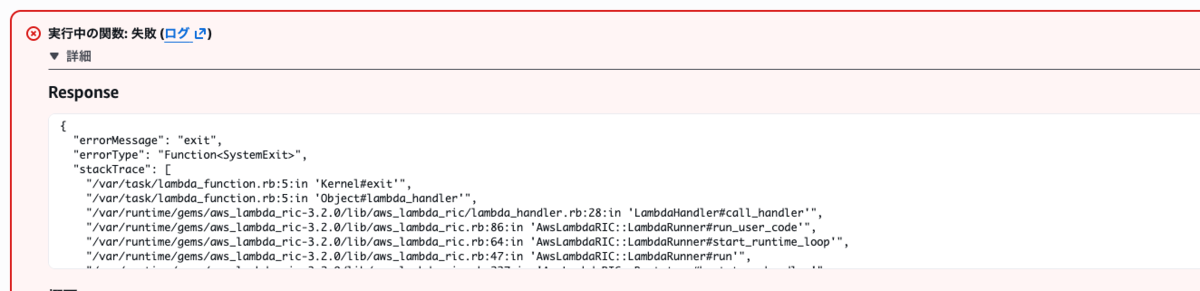
exit(0) を実行すると、Lambda関数としては失敗扱いとなります。

exit(1) も失敗する

同様にexit(1)を考えます。

def lambda_handler(event:, context:)
  exit(1)
end

こちらも当然、Lambda関数は失敗します。

4つのパターンを整理する

ここまでの内容を表にまとめると、次のようになります。

Rubyコード Lambda関数 理由
return { statusCode: 500, ... } 成功 ハンドラーが正常に戻り値を返している
raise "error" 失敗 未処理の例外が発生している
exit(0) 失敗 ハンドラーの戻り値を返す前にプロセスが終了する
exit(1) 失敗 ハンドラーの戻り値を返す前にプロセスが終了する

このことから、Lambda関数の成功・失敗を考える際には、HTTPステータスコードではなく、Lambdaランタイムから見て関数実行が正常に完了したかという視点を持つことが重要です。